Cada vez me cuesta más entender hacia dónde va la IA. Casi todas las semanas parece traer otro avance, otra advertencia o una nueva afirmación de que algún problema fundamental ha sido resuelto.
En general, la dirección parecía clara: hacer los modelos generales más capaces, darles más conocimiento, más contexto, más herramientas, más tiempo para razonar y, cada vez más, permitirles actuar por su cuenta. Cuando eso no es suficiente, escalar aún más.
Incluso hay una idea teológica1 escondida en esta dirección: seguir acumulando capacidades en una inteligencia general lo suficientemente poderosa como para que, eventualmente, podamos llevarle casi cualquier problema. Este enfoque nos ha llevado sorprendentemente lejos, pero las consecuencias de seguir empujando esa frontera son cada vez más difíciles de ignorar, al punto de que Dario Amodei ha planteado que quizá necesitemos moderar el ritmo de avance de la frontera.
La generalidad es lo que hace extraordinarios a estos modelos. Pero vale la pena preguntarnos si llevar más lejos la inteligencia general es la única frontera que vale la pena explorar.
Una frontera diferente
Aquí aparece Jev, el primer modelo público de TypeSafe, una compañía fundada por un exinvestigador de OpenAI que participó en la creación de ChatGPT.
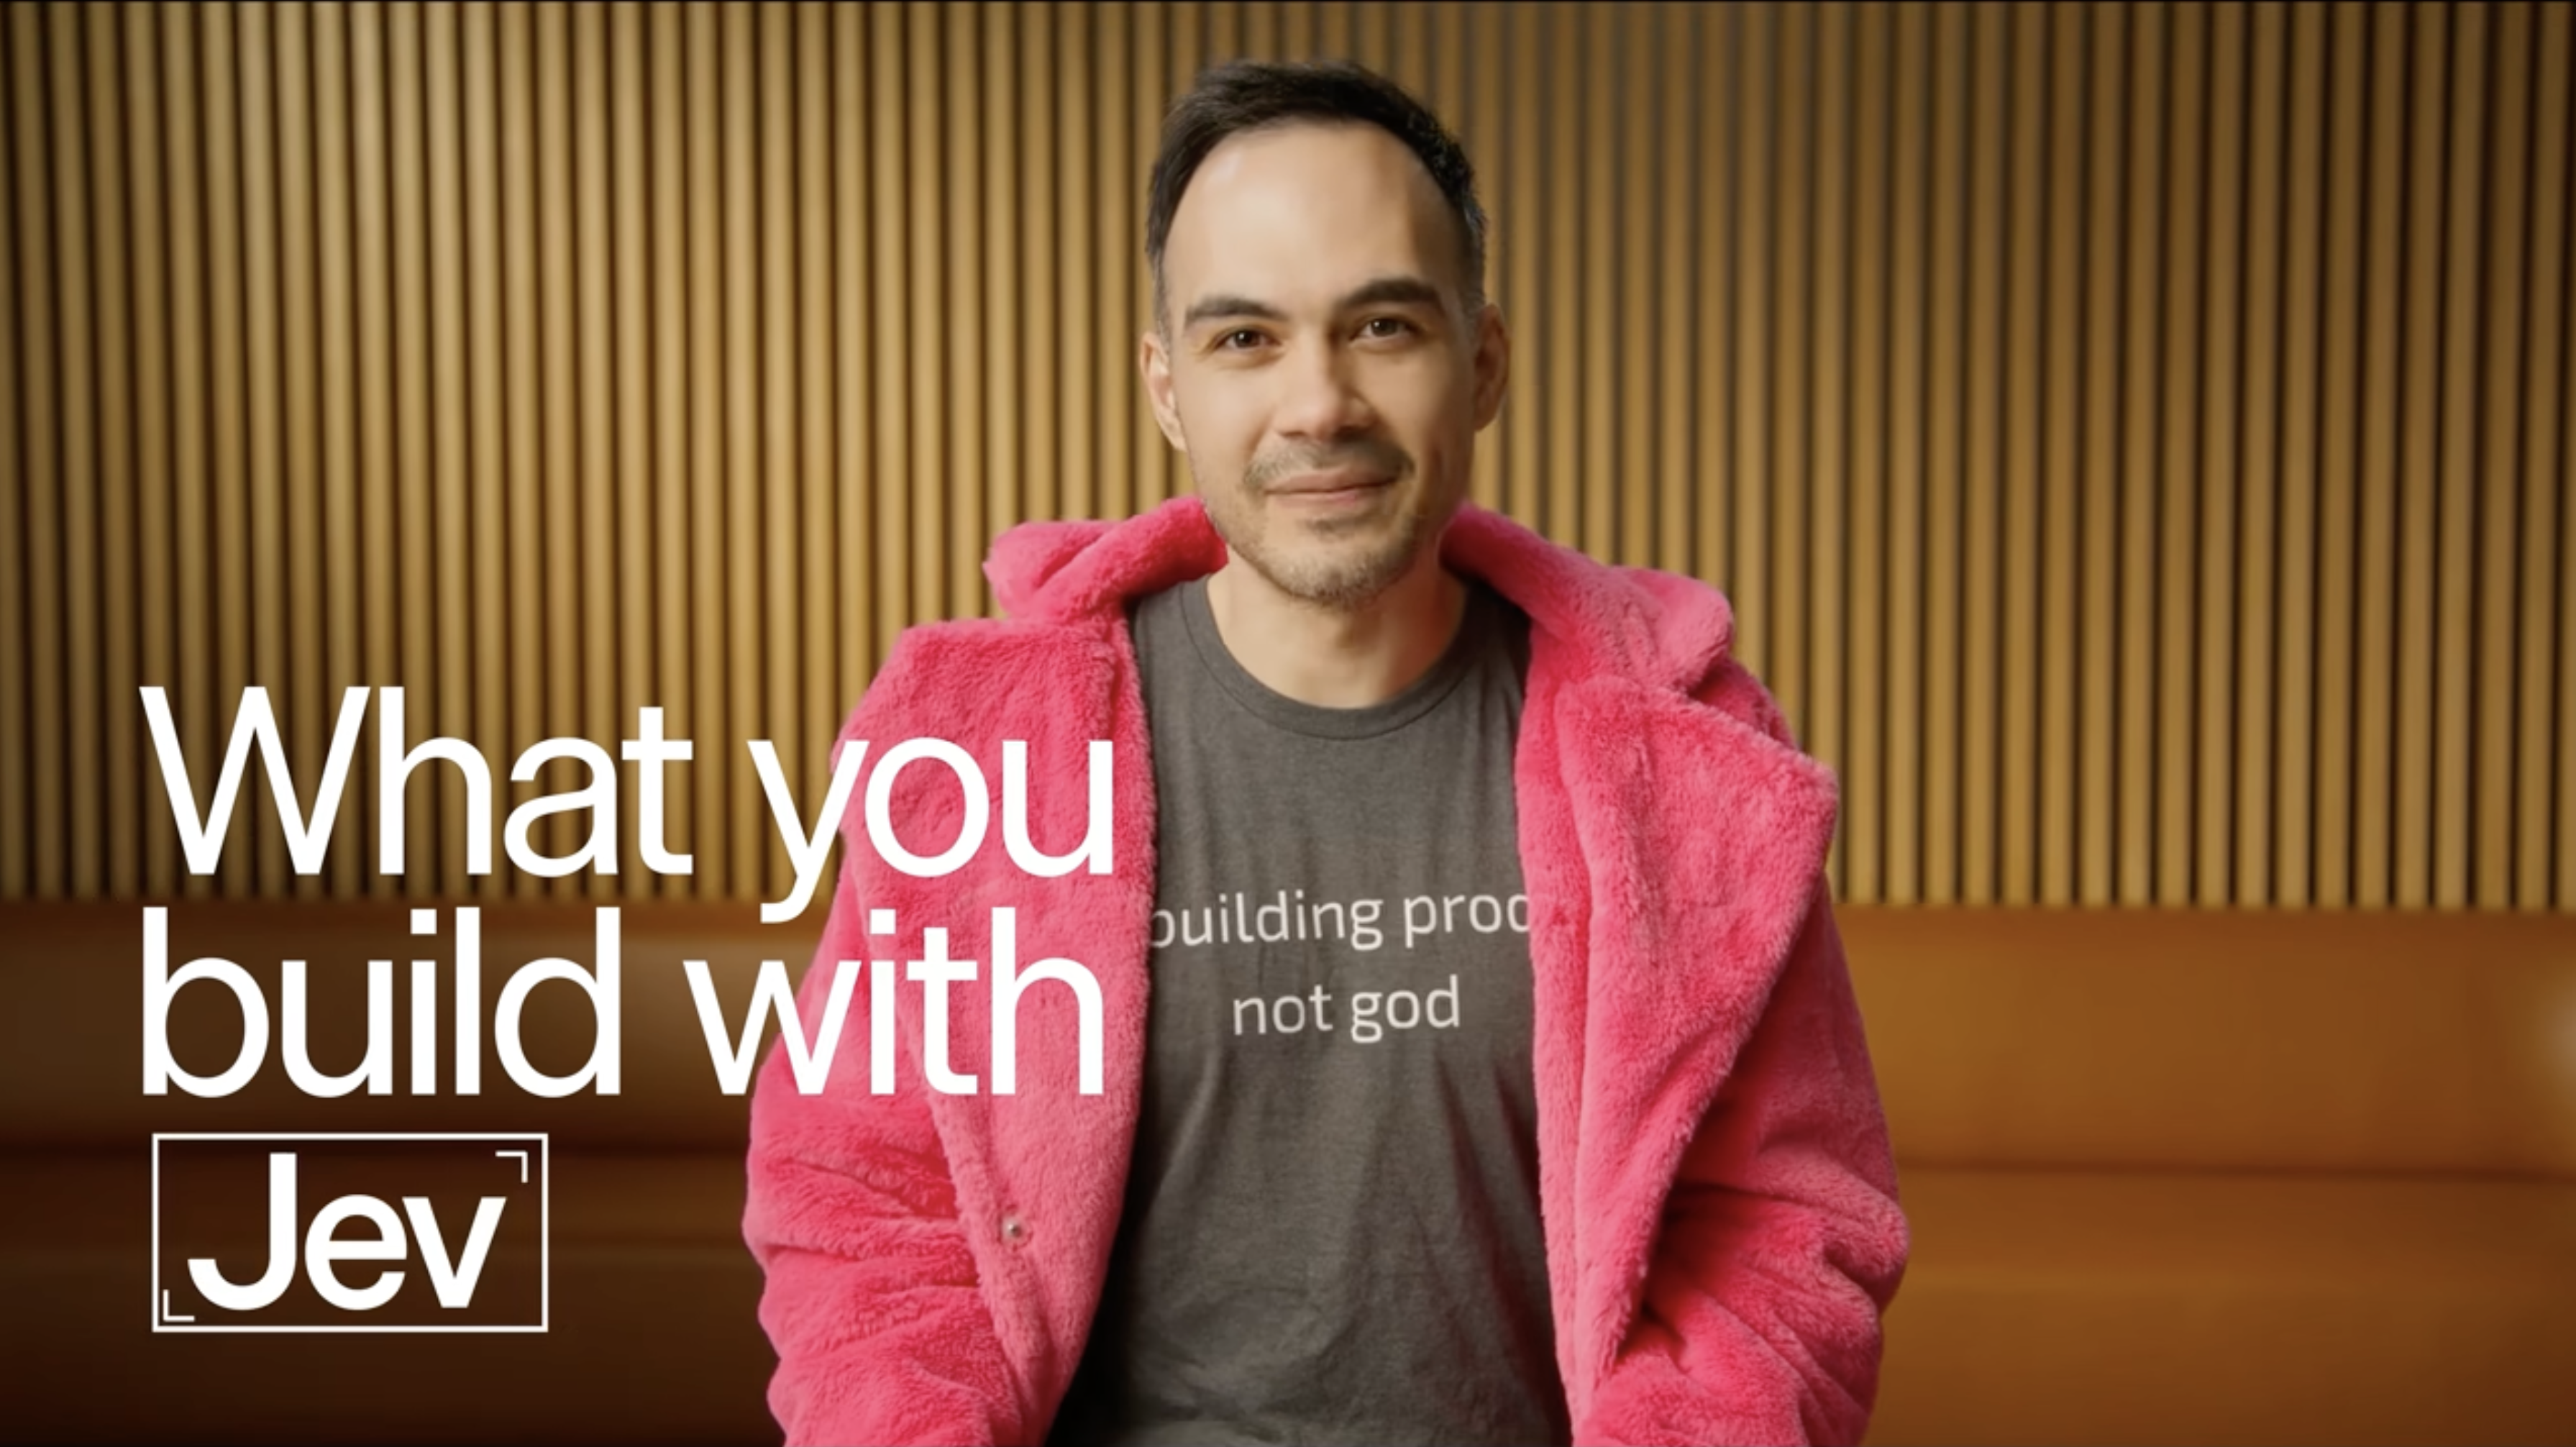
Jev se siente como un aire fresco al ver a Diogo Almeida explicar el modelo usando outfits coloridos en la presentación y con un mensaje igual provocador: “We’re building prod, not God.” La forma y la idea parecen reforzarse entre sí y es una manera muy distinta de presentar lo que podría ser un modelo de frontera.
El objetivo de este modelo es distinto: decisiones rápidas y estructuradas que el software pueda utilizar directamente. Está entrenado con un nuevo método llamado Reinforcement Learning for Calibrated Decisions (RLCD). En lugar de producir respuestas abiertas, Jev recibe un conjunto de resultados posibles y devuelve una distribución de probabilidad entre ellos.
Esto hace que interactuar con el modelo sea muy distinto de escribir un prompt para un LLM. Por ejemplo, no le pides a Jev que explique cuál podría ser el perfil de un candidato. Defines los perfiles posibles, proporcionas la evidencia y le pides que juzgue entre ellos. El resultado no es texto generado, sino una decisión estructurada junto con la incertidumbre del modelo sobre las alternativas.
TypeSafe presenta a Jev como un modelo de frontera, y eso me hace preguntar: ¿qué tipo de frontera es esta? Su capacidad es más acotada y específica: tomar una decisión explícita a partir de evidencia y devolver un resultado sobre el que otro programa pueda actuar. Esa especificidad también se manifiesta en el escepticismo presente en las reacciones al lanzamiento: si al final este modelo es solo un clasificador, ¿por qué tanto hype?
Taxonomías
Theo Browne se acerca a esta pregunta en su reseña de Jev. Destaca lo que el modelo hace en la práctica: clasificación, ranking y decisiones estructuradas sobre datos. Este encuadre hace que el escepticismo sea fácil de entender: la clasificación es uno de los problemas más antiguos del machine learning y hemos tenido clasificadores durante décadas.
Pero la clasificación tiene una propiedad interesante que es fácil pasar por alto: el clasificador no define las categorías en las que clasifica.
Los seres humanos siempre hemos organizado el mundo poniendo las cosas en grupos: comestible o venenoso, salvaje o domesticado, terrestre o acuático, un tipo de planta o animal y otro. Antes de que algo pueda clasificarse, ya debe existir un conjunto de categorías en el cual clasificarlo.
Y a medida que esas categorías crecen, también pueden agruparse, dividirse, nombrarse y relacionarse entre sí. Lo que comienza como clasificación se convierte en un sistema para organizar un dominio: una taxonomía.
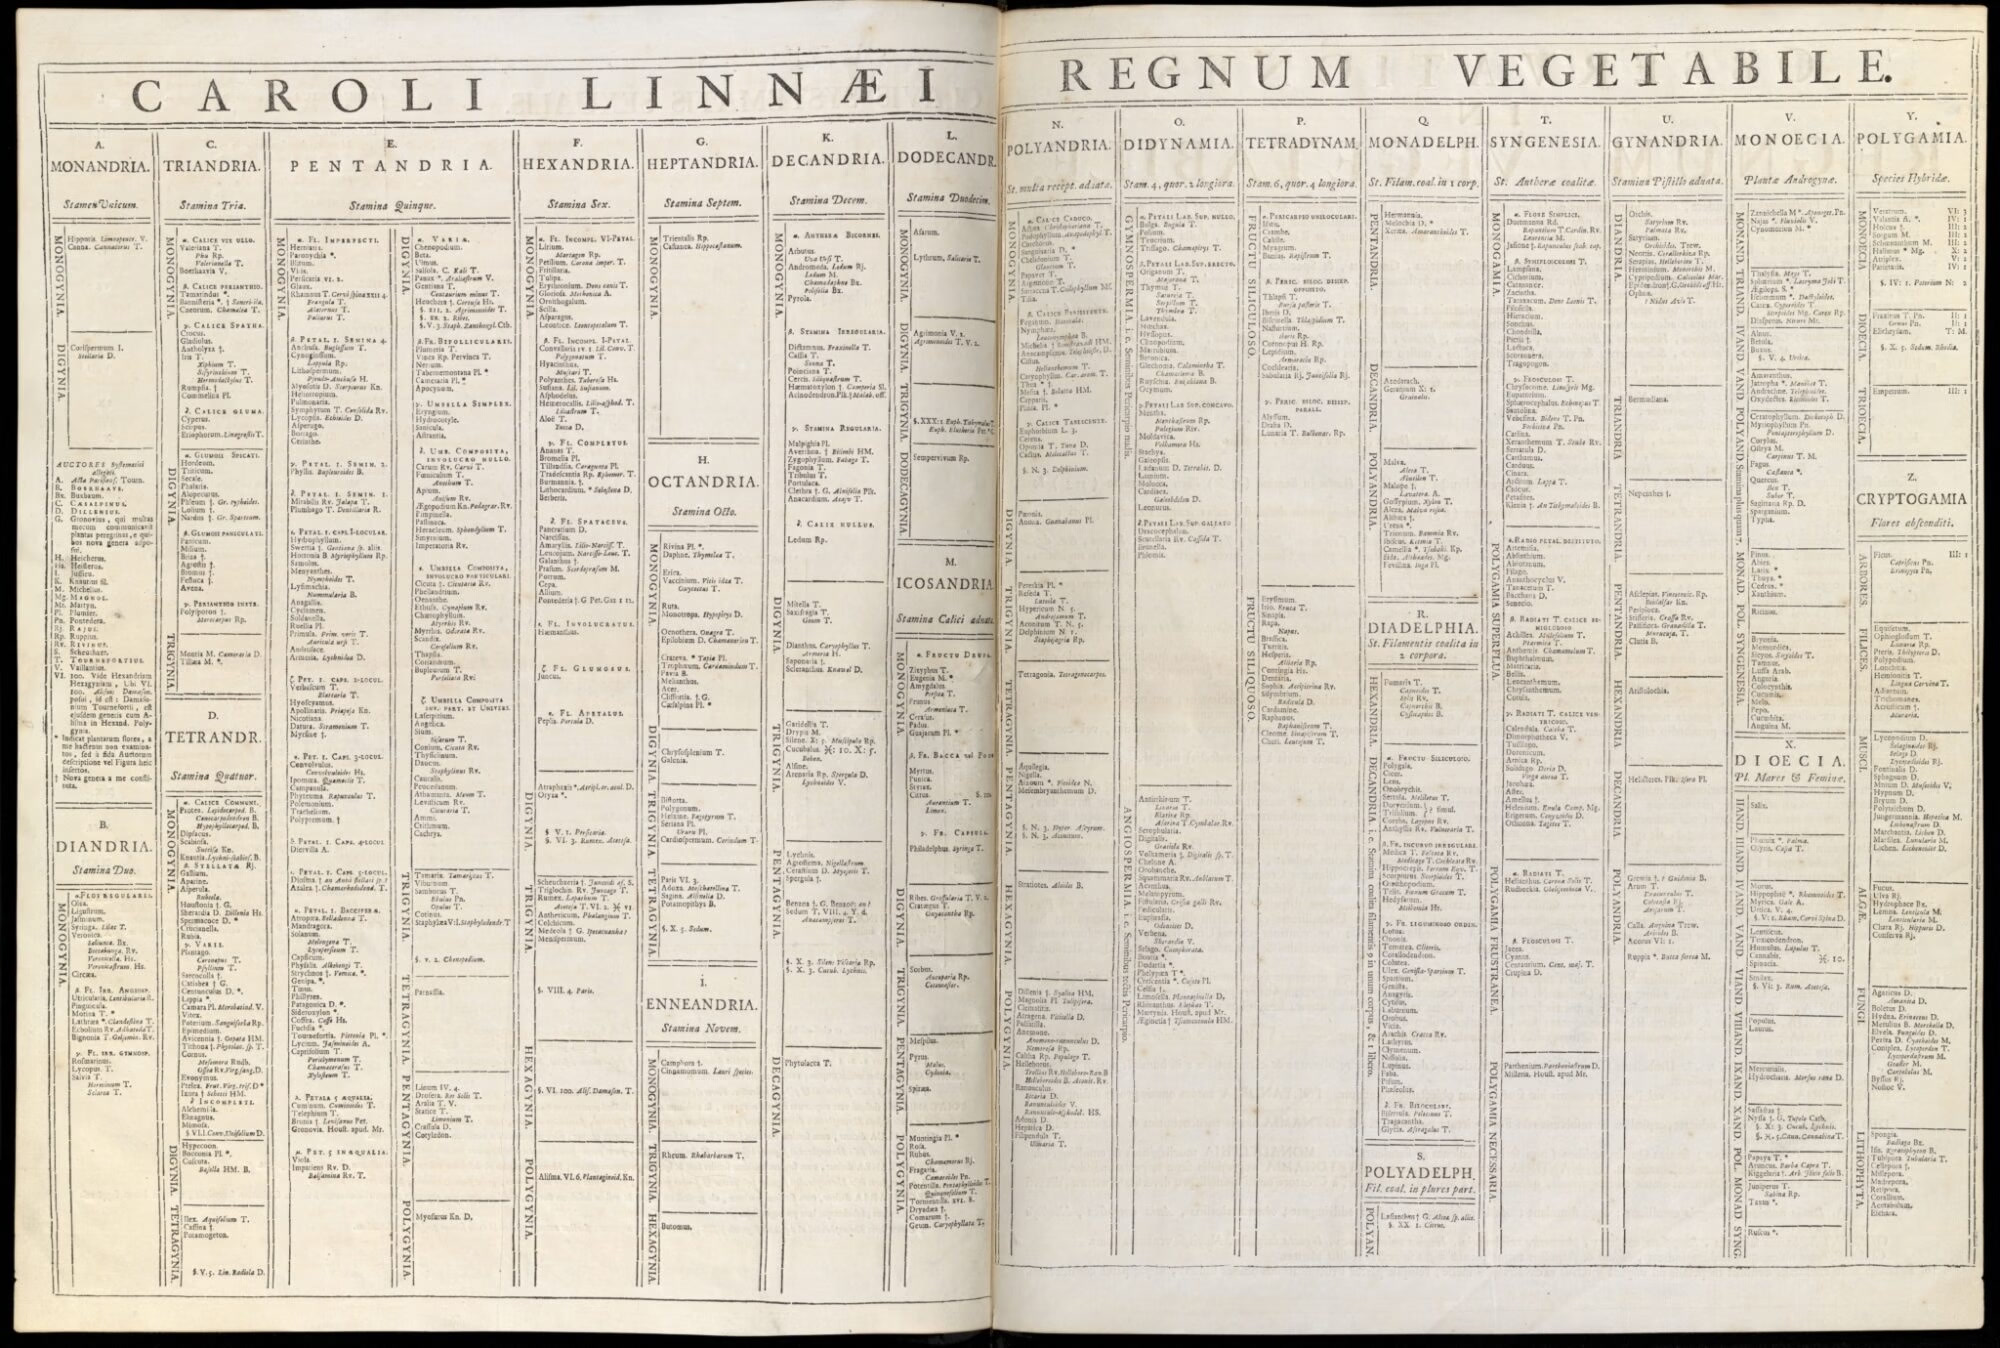
Carl Linneo, conocido con frecuencia como el padre de la taxonomía moderna, construyó uno de sus ejemplos más influyentes hace casi 300 años. En 1735 publicó la primera edición de Systema Naturae. Las clasificaciones cambiarían considerablemente. Linneo revisó el sistema a lo largo de varias ediciones y la ciencia posterior reemplazaría muchas de las distinciones que utilizó. Pero lo que resultó más duradero fue la estructura: nombres, categorías, atributos y relaciones capaces de organizar un dominio enorme de plantas, animales y minerales, y de ubicar una cosa en relación con otra.
Así que quizá decir “solo un clasificador” describe lo que ocurre al final, pero no todo lo necesario para hacer posible esa clasificación.
Esto se volvió mucho más claro cuando intenté poner a Jev a trabajar.
Poniendo a Jev a trabajar
Quería una tarea lo suficientemente pequeña como para poder definir no solo la decisión, sino también las condiciones a su alrededor. Elegí algo que me resultaba familiar: mirar un currículum y decidir qué tipo de perfil profesional respaldaba realmente la evidencia. Documenté el experimento, incluyendo el código y los resultados, en GitHub.
Creé ocho currículums sintéticos y cuatro decisiones, cada una planteando una pregunta ligeramente distinta:
| Decisión | Qué pregunta | Resultado |
|---|---|---|
technical_depth | ¿Qué tanta experiencia práctica en ingeniería demuestra la evidencia? | 0–5 |
primary_profile | ¿Qué perfil profesional está mejor respaldado por la evidencia? | Opción |
production_ai_ownership | ¿El currículum muestra responsabilidad directa sobre IA en producción? | Sí / No |
recent_hands_on_engineering | ¿Muestra trabajo práctico reciente en ingeniería? | Sí / No |
El objetivo no era reproducir un proceso de contratación. Era crear un entorno acotado donde la evidencia, las decisiones posibles y mis expectativas pudieran hacerse explícitas.
Después procesé los mismos currículums con tres modelos diferentes. Elegí deliberadamente modelos que abordaban la tarea de formas distintas. El objetivo no era hacer un benchmark entre modelos equivalentes, sino comparar tres maneras de convertir la misma evidencia en una decisión.
| Enfoque | Modelo | Cómo se produce la decisión |
|---|---|---|
| Modelo de decisión | Jev | Elige entre un conjunto fijo de resultados válidos y devuelve una distribución de probabilidad entre ellos |
| Modelo generativo | OpenAI Luna | Lee la evidencia y genera una respuesta estructurada restringida a un esquema JSON |
| Reranker | Qwen3 Reranker 8B | Puntúa los posibles resultados según su relevancia, permitiendo ordenarlos |
Cada modelo recibió la misma evidencia de los currículums y las mismas definiciones de las decisiones, pero tanto el mecanismo como los resultados eran distintos. Jev recibió directamente las opciones válidas y devolvió probabilidades para cada una; Luna recibió instrucciones y un esquema para generar una respuesta estructurada; y Qwen ordenó cada posible respuesta con respecto a la evidencia, produciendo puntuaciones en lugar de probabilidades. Por eso me interesaba menos qué modelo ganaba que lo que cada enfoque ponía a disposición del software que lo rodeaba, aunque fue sorprendente ver a Jev devolver las cuatro decisiones con tanta rapidez y consistencia durante todo el experimento.
En los ocho currículums, los modelos llegaron con frecuencia a decisiones similares, aunque hubo algunos desacuerdos interesantes. Luna, por ejemplo, clasificó el currículum de AI Product Manager como Technical Product Manager en una de las ejecuciones.
La decisión más reveladora, sin embargo, fue technical_depth. Como sus respuestas posibles formaban una escala, podía ver no solo qué nivel elegía Jev, sino también cómo distribuía su confianza entre niveles contiguos. En uno de los currículums, consideraba que tanto 3 como 4 eran resultados razonables. Jev asignó cerca de 79% de probabilidad a 4 y 21% a 3. En lugar de ocultar la ambigüedad detrás de una sola puntuación, el resultado la conservó.
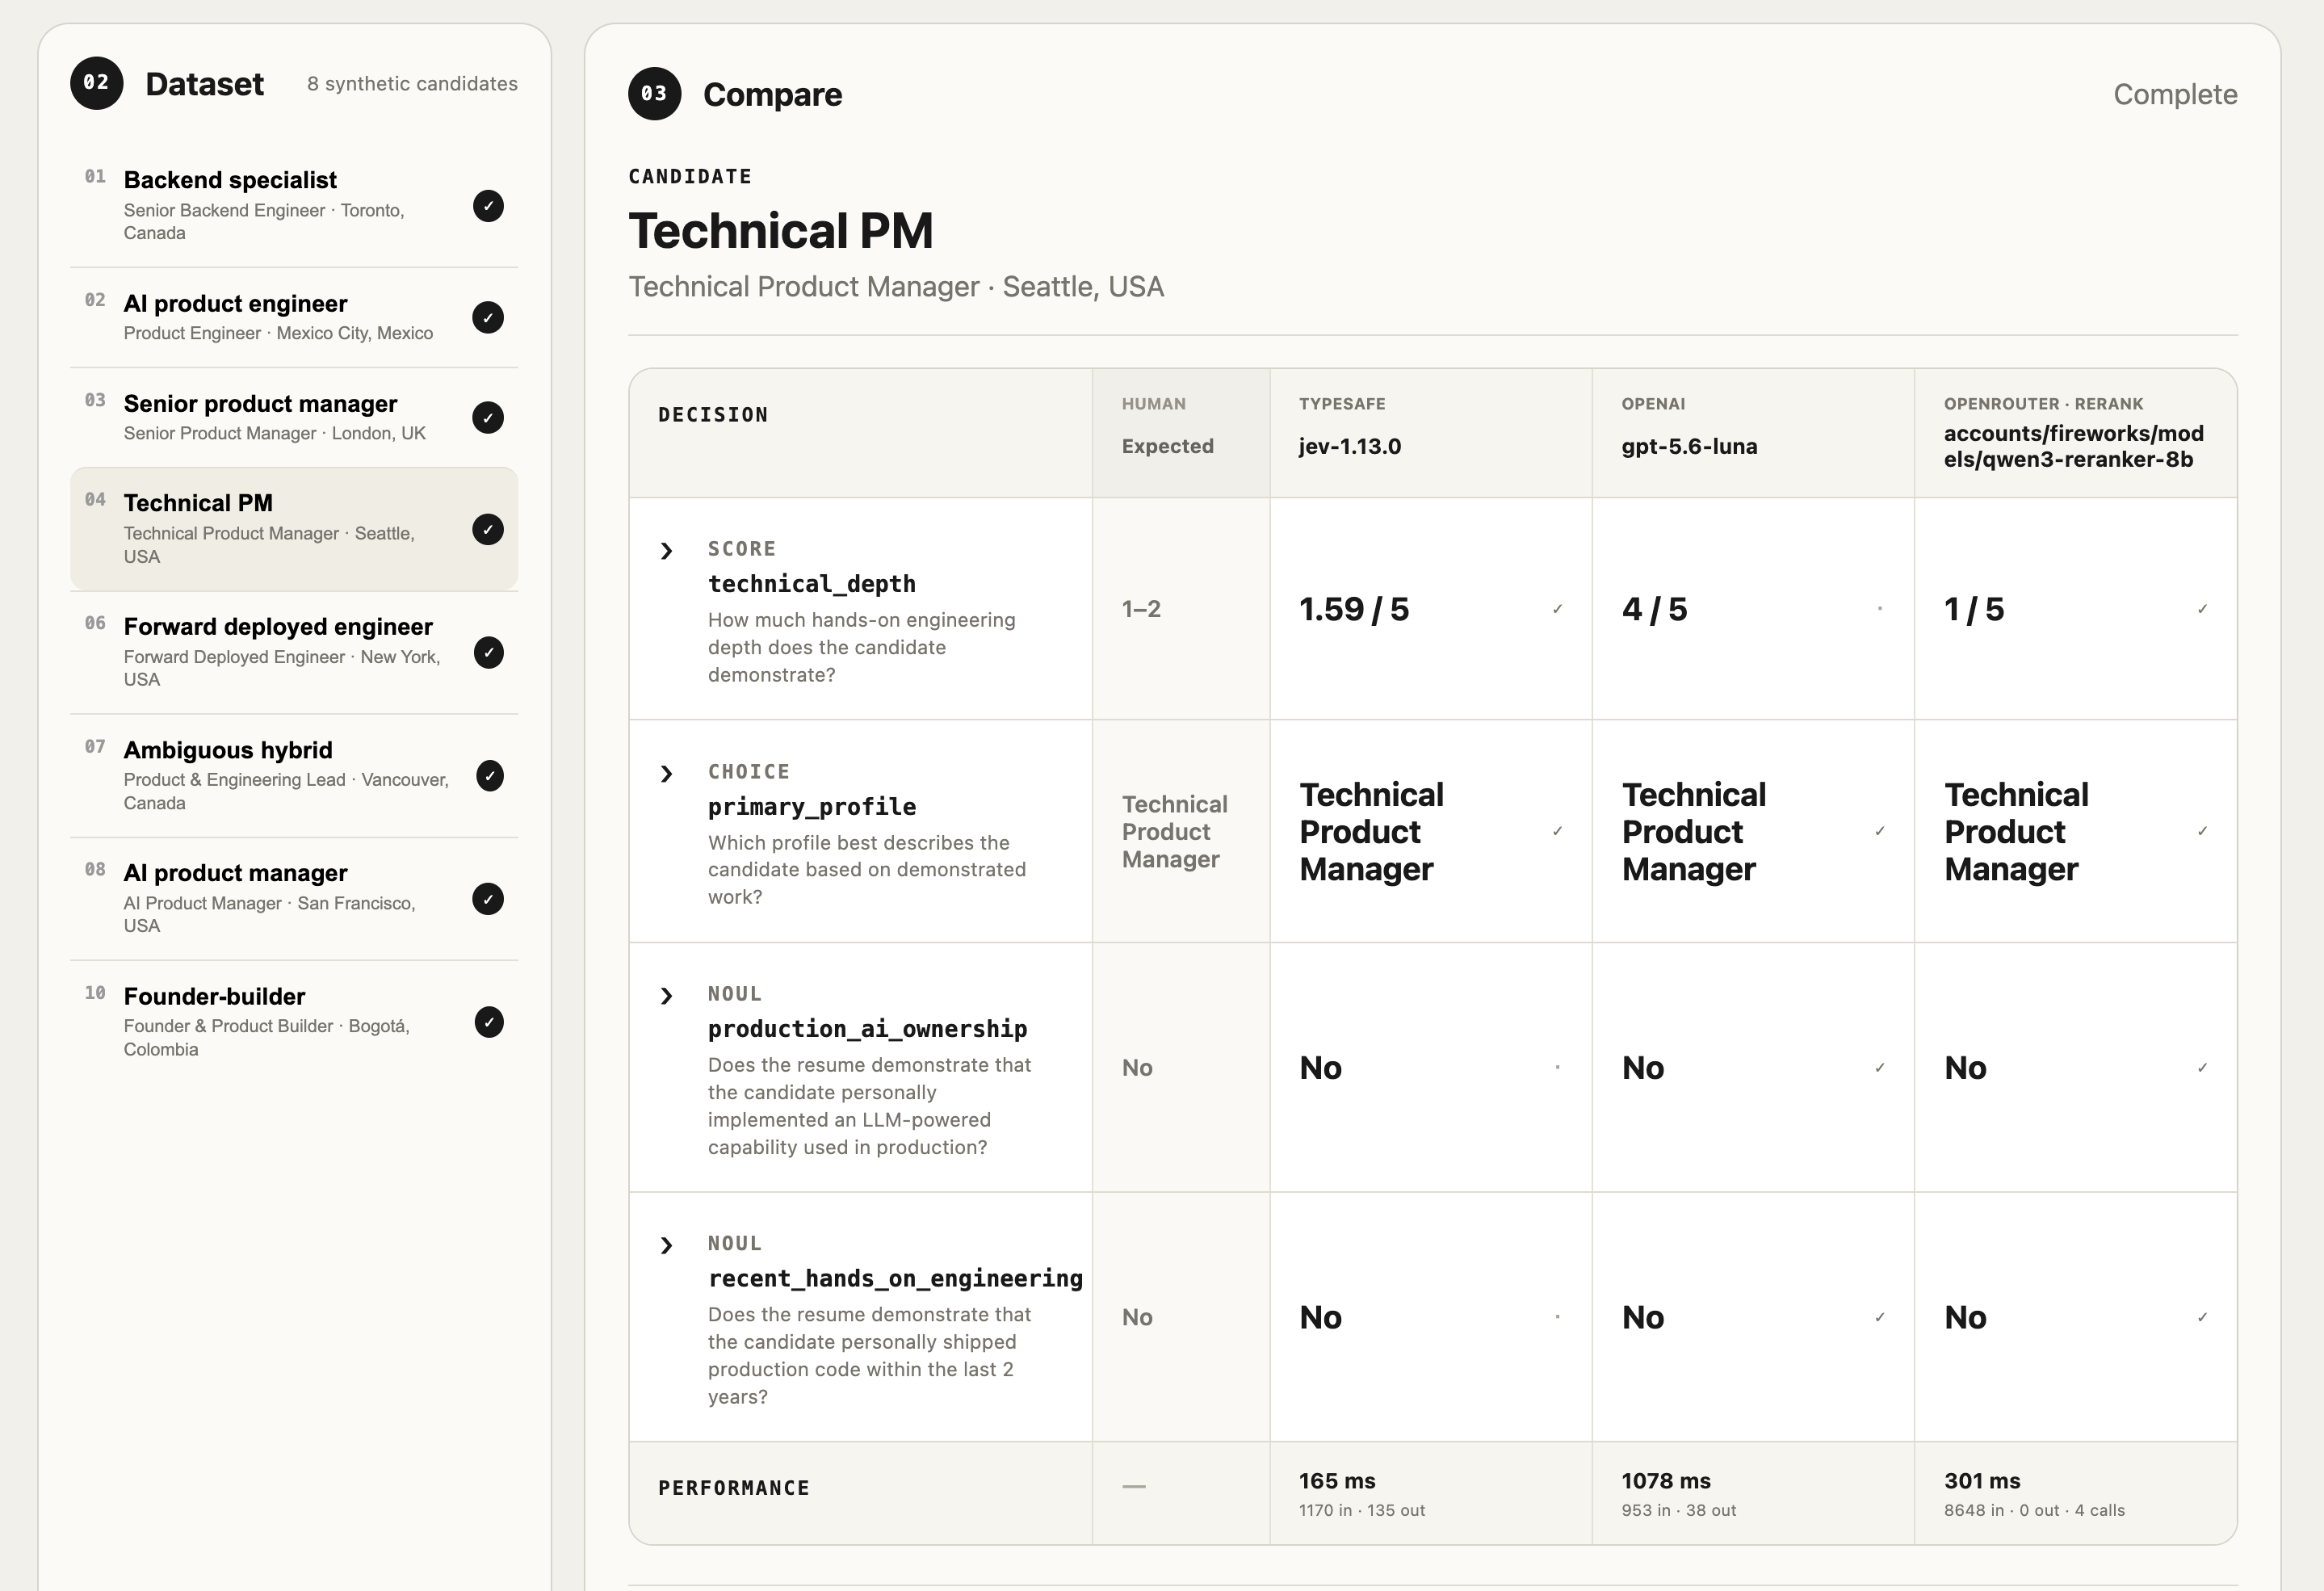
Lo que me interesó fue que la incertidumbre misma quedó disponible para el software. Jev no solo devolvió una decisión: hizo visible con qué fuerza la evidencia respaldaba las alternativas que yo había definido.
Esa incertidumbre podía convertirse en parte del comportamiento del sistema. Una decisión 80/20 podría aceptarse automáticamente, mientras que una 51/49 podría activar una revisión o pedir más evidencia.2
Esto también reveló otra parte del experimento: la decisión era más grande que el modelo que emitía el juicio. Jev evaluaba la evidencia, pero los resultados posibles, su significado y lo que ocurría después estaban definidos por el sistema que lo rodeaba.
Juicio explícito
El experimento tenía dos lados. Los modelos debían interpretar la evidencia y emitir un juicio, pero yo tenía que definir el espacio en el que ese juicio podía ocurrir: qué significaba technical_depth, qué resultados eran posibles y dónde se encontraban, aproximadamente, los límites entre ellos.
Esas definiciones también me dieron una manera de evaluar los resultados. Cada currículum tenía una decisión esperada, o un rango aceptable, revisada por una persona y mantenida fuera de las instrucciones del modelo. En lugar de preguntar si los modelos coincidían entre sí, podía comparar sus decisiones con el juicio que yo había codificado.
Eso es, en esencia, lo que hace una evaluación de IA: nos da una forma repetible de probar el comportamiento de un modelo frente a un resultado o criterio esperado. Sin embargo, a diferencia de una prueba de software tradicional, el resultado suele ser probabilístico o subjetivo, así que la evaluación misma puede requerir juicio.
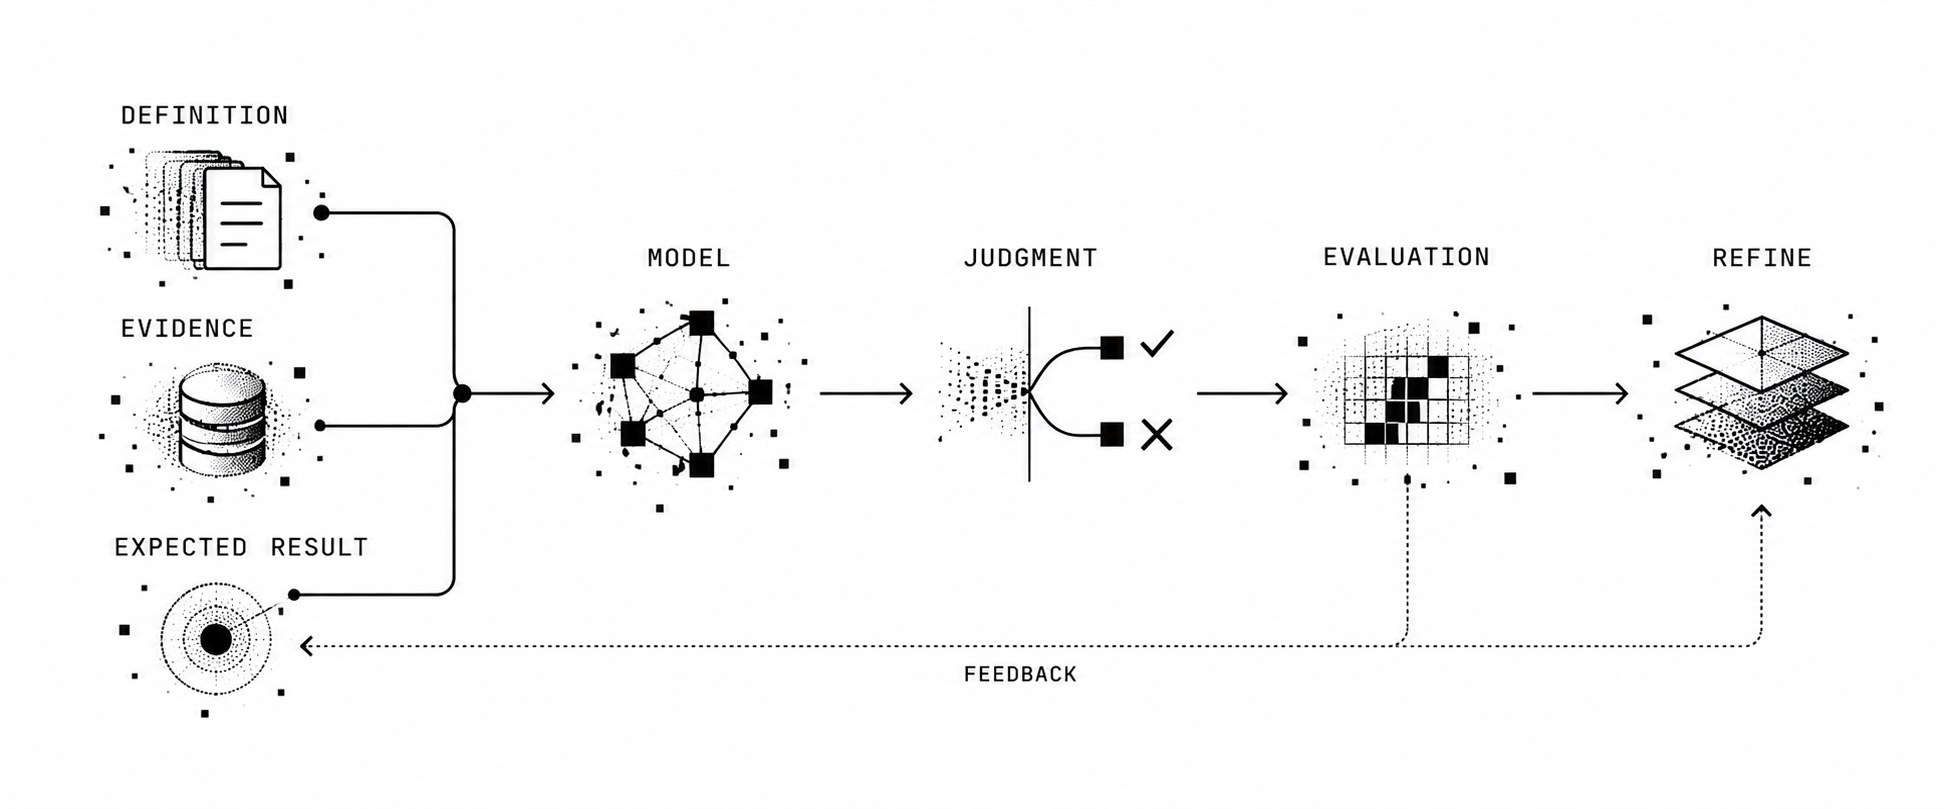
Crear la primera evaluación fue relativamente sencillo. Mantenerla sería más difícil. Un nuevo currículum podría revelar una distinción que yo no había considerado. Dos casos que parecían equivalentes podrían resultar no serlo. A veces tendría que cambiar el resultado esperado; otras veces, la definición misma.
Esto hace que las evaluaciones sean más interesantes que una simple prueba de aprobado o reprobado. Evaluar el modelo también nos obliga a refinar el juicio que le estamos pidiendo hacer.
Pero un juicio como technical_depth no existe por sí solo. Para definirlo, también tuve que establecer qué contaba como experiencia, responsabilidad, complejidad técnica y evidencia de cada una. Hacer explícito el juicio también significaba hacer explícito su dominio.
El dominio detrás de la decisión
Esa estructura se extiende más allá de la decisión misma. technical_depth solo tiene sentido dentro de un pequeño dominio de conceptos relacionados: los candidatos tienen experiencias, esas experiencias aportan evidencia y esa evidencia respalda un juicio sobre la profundidad técnica.
Candidato → Experiencia → Evidencia → Profundidad técnica → DecisiónCuando estos conceptos y relaciones se hacen explícitos, comienzan a formar una representación del dominio mismo: qué tipos de cosas importan para la decisión, qué propiedades tienen y cómo se relacionan entre sí3. Ya no se trata solo de un conjunto de respuestas posibles, sino de una estructura que conecta la evidencia con el juicio que queremos que el modelo haga.
El software se ha apoyado desde hace mucho tiempo en representaciones explícitas de los dominios. Las codificamos en esquemas, tablas, clases, tipos, relaciones y reglas para que los programas puedan operar sobre ellas. Los grandes modelos de lenguaje redujeron ese requisito. Como pueden inferir conceptos y relaciones a partir del lenguaje, buena parte de la estructura que antes debíamos especificar para el software podía permanecer implícita.
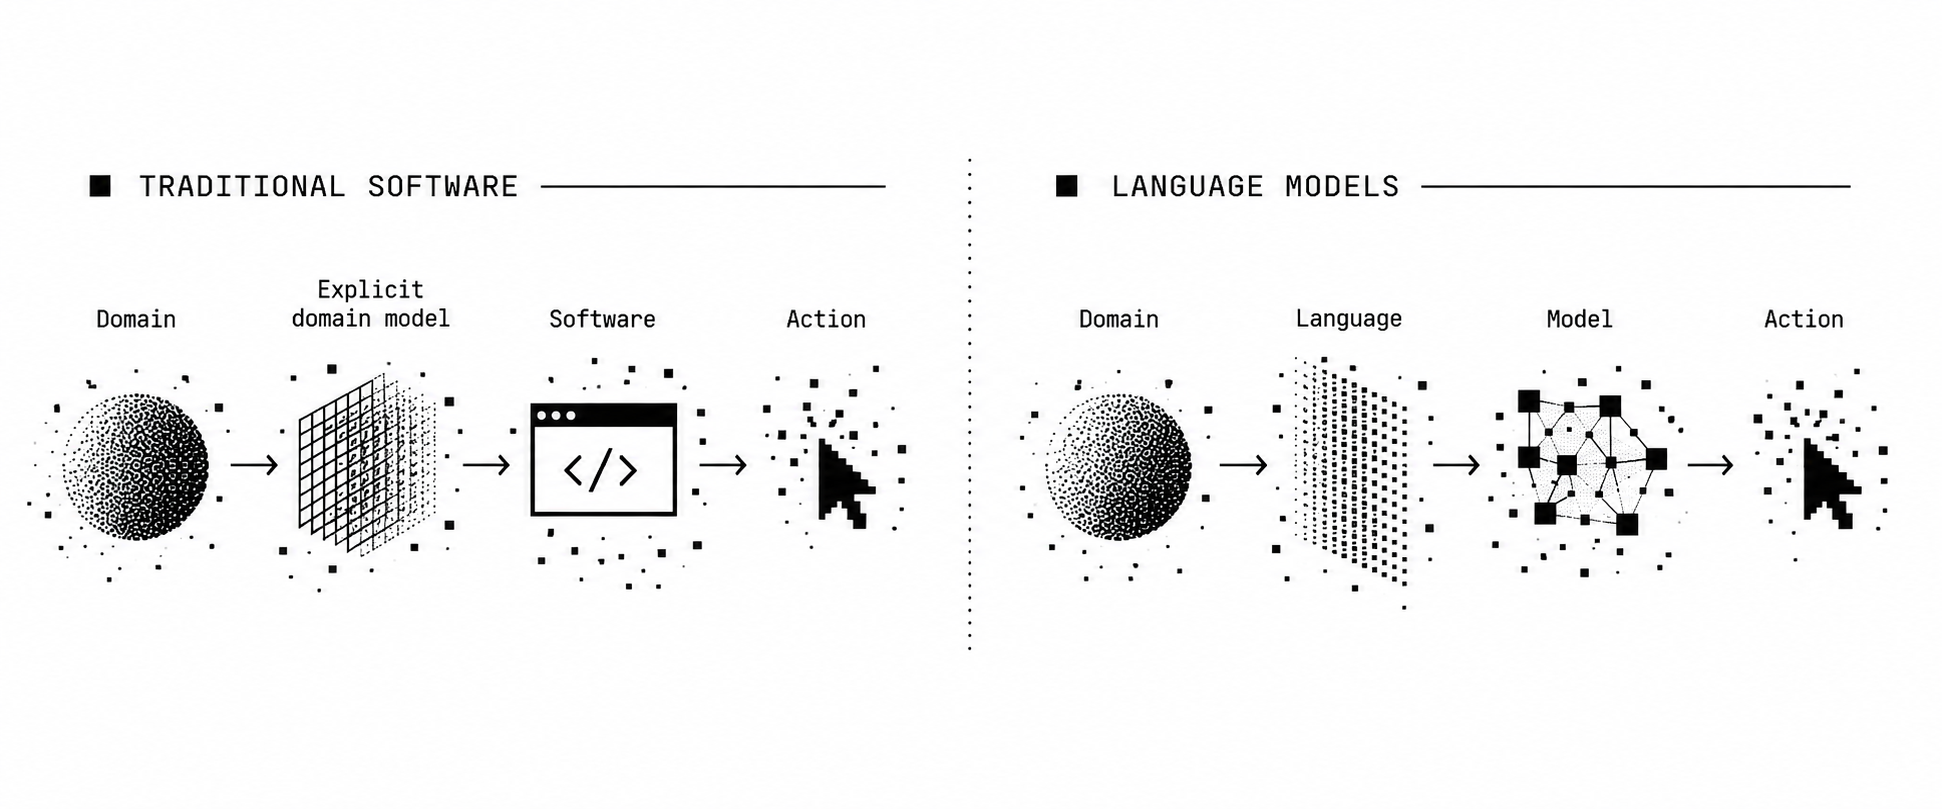
En cuanto quisimos que el juicio fuera más específico y evaluable, parte de esa estructura comenzó a regresar. El modelo podía evaluar la evidencia, pero todavía teníamos que decidir qué contaba como evidencia, qué conceptos importaban, cómo se relacionaban entre sí y dónde estaban los límites de la decisión.
Esto no significaba modelar todo el dominio. Un candidato es, evidentemente, más que su experiencia, y su experiencia es más que la evidencia disponible en un currículum. Solo necesitábamos la estructura suficiente para que este juicio particular tuviera sentido.
Y eso revela una tensión interesante: cuanto menos le pedimos resolver al modelo, más tenemos que resolver nosotros.
La necesidad de hacer explícita la estructura de un dominio me recordó una idea que conocí por primera vez a través de la arquitectura de información.
Arquitectura de información
Hace años encontré un breve artículo del diseñador Mark MacKay cuyo título se me quedó grabado: “Carolus Linnæus, el primer arquitecto de información”. El texto tiene apenas unos cuantos párrafos y buena parte de la idea ya está contenida en el título.
El artículo también tiene un tono divertido. Ahí aprendí que a Linneo le gustaba la frase “Dios crea, Linneo organiza”. Y que, después de que el botánico Johann Siegesbeck criticara su sistema de clasificación, Linneo nombró Siegesbeckia en su honor a una planta pequeña y de olor desagradable.
MacKay llamó a Linneo arquitecto de información. El término encaja porque su trabajo no era simplemente clasificar. Systema Naturae le dio una estructura a la información. Las observaciones individuales ya existían, pero la arquitectura era el sistema que permitía leerlas en conjunto.
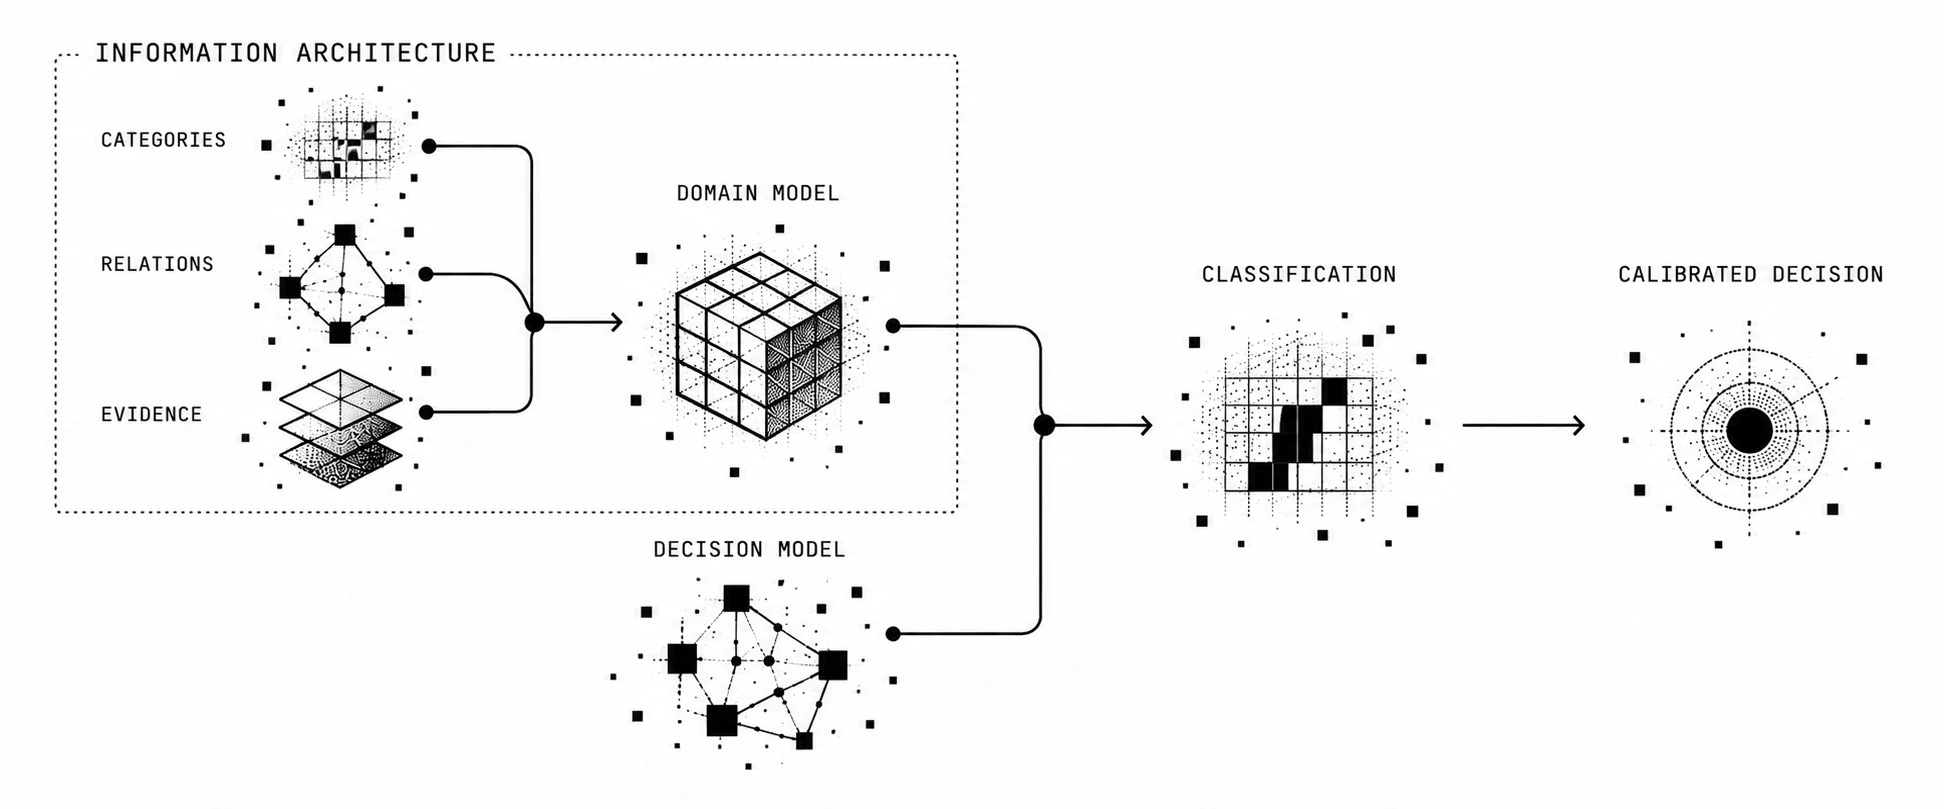
La arquitectura de información suele asociarse con sitios web, pero el problema subyacente es más amplio. Consiste en organizar información para que un dominio complejo pueda entenderse y utilizarse. Una taxonomía es una parte de esa estructura; las definiciones, las relaciones y las formas de navegar entre conceptos son otras.
Esto vuelve más concreta la conexión con Jev. No solo le dimos información al modelo. Progresivamente le dimos estructura a esa información: opciones entre las cuales distinguir, definiciones contra las cuales juzgar, evidencia que considerar y un dominio en el que esas decisiones tenían significado.
Aquí es donde Jev comienza a verse distinto de la forma en que nos hemos acostumbrado a trabajar con grandes modelos de lenguaje.
Con un LLM y la IA generativa, buena parte de la estructura puede permanecer implícita. Describimos el problema en lenguaje natural y confiamos en que el modelo reconstruya el dominio, infiera las distinciones relevantes y decida qué importa. Jev mueve parte de ese trabajo fuera del modelo. La inteligencia se vuelve más acotada, pero el mundo que la rodea necesita ser más explícito.
Las taxonomías y los modelos de dominio le dan estructura a ese mundo. Establecen qué existe, qué puede distinguirse y qué cuenta como evidencia para un juicio. En ese sentido, la arquitectura de información no consiste simplemente en organizar información para un sistema inteligente. Define el mundo en el que esa inteligencia tiene algo específico que hacer.
Esto es lo que hace que Jev me parezca más interesante que “solo un clasificador”. La frontera que señala no es simplemente otra capacidad para añadir a un modelo cada vez más general. Sugiere que el progreso también puede ocurrir alrededor del modelo: en la precisión con la que definimos un dominio, estructuramos su información y diseñamos las decisiones que queremos que la inteligencia tome.
Esta es una dirección muy distinta de poner cada vez más del mundo dentro del modelo.
Conclusión
Jev comenzó como un contrapunto interesante a la dirección que parecía estar tomando la IA. Lo que al principio parecía un modelo más acotado se convirtió, poco a poco, en una manera diferente de pensar de dónde proviene la inteligencia de un sistema.
La inteligencia general nos anima a pensar en términos de acumulación: más conocimiento, más razonamiento, más herramientas, más autonomía, hasta que suficientes capacidades comiencen a converger en el mismo modelo. Jev hace casi lo contrario. Le da al modelo un trabajo más específico y nos obliga a diseñar con mayor intención a su alrededor.
Esa diferencia importa más allá de la arquitectura. Cuando una capacidad tiene un dominio definido, decisiones explícitas y criterios observables de éxito, comienza a parecerse más a algo que ya sabemos cómo construir. Podemos describirla, probarla, combinarla con otras capacidades, restringirla y hacerla responsable de funciones particulares. La seguridad deja de consistir tanto en controlar una inteligencia capaz de hacer casi cualquier cosa y pasa a consistir en diseñar sistemas cuyo comportamiento podamos especificar y evaluar.
Quizá por eso importa esta distinción. El futuro de la IA no tiene que entenderse únicamente como una carrera hacia una inteligencia cada vez más general. Parte de su progreso más importante podría venir no de hacer la inteligencia más general, sino de hacer sus límites más explícitos.
Notas al pie
-
Esta idea no es del todo retórica. En 2023, Ilya Sutskever y Jan Leike describieron la superinteligencia como potencialmente “la tecnología más impactante que la humanidad haya inventado”, capaz de ayudarnos a resolver muchos de los problemas más importantes del mundo. ↩
-
Con solo ocho currículums sintéticos, el experimento era demasiado pequeño para evaluar si las probabilidades de Jev estaban realmente bien calibradas. En un modelo bien calibrado, las predicciones hechas con 79% de confianza deberían ser correctas alrededor de 79% de las veces a lo largo de muchos casos comparables. Tanto Jev como Luna evaluaron las cuatro decisiones en una sola solicitud; el reranker usó cuatro solicitudes ejecutadas en paralelo. Las ejecuciones y otras observaciones están descritas en las notas del experimento. ↩
-
Una versión más formal de esta idea es una ontología: una representación explícita de los conceptos de un dominio, sus propiedades y las relaciones entre ellos. ↩